Jev: het AI-model dat beslissingen teruggeeft in plaats van tekst
Met Jev introduceert TypeSafe een model dat geen tekst genereert, maar getypte, probabilistische beslissingen neemt. Dit biedt nieuwe mogelijkheden en snelheden voor geautomatiseerde agentic workflows, al ontbreken onafhankelijke benchmarks nog.
De wereld van generatieve kunstmatige intelligentie draait al jaren vrijwel uitsluitend om tekst. Modellen schrijven complexe programmeercode, stellen genuanceerde e-mails op en genereren paginalange rapporten. Maar naarmate AI steeds dieper wordt geïntegreerd in geavanceerde automatiseringstaken, ontstaat er een fundamenteel andere behoefte: de vraag naar extreem snelle, betrouwbare en machine-leesbare beslissingen. In veel bedrijfsprocessen is een heel opstel als antwoord overbodig; systemen hebben slechts een gestructureerde uitkomst nodig. Onlangs lanceerde de startup TypeSafe na een periode van ruim twee jaar stealth hun antwoord op dit specifieke probleem. Hun nieuwe model, genaamd Jev, is momenteel beschikbaar in early access. Met een recente investering van 40 miljoen dollar door onder meer investeringsfonds DCVC op zak, beloven de oprichters Diogo Almeida, Erik Gafni en Sasha Sheng een significante verschuiving in hoe we AI-agents ontwerpen en inzetten.
De verschuiving van tekstgeneratie naar robuuste besluitvorming
Om te begrijpen waarom de lancering van Jev opmerkelijk is, moeten we kijken naar de huidige staat van AI-implementaties. Bij het bouwen van betrouwbare systemen spenderen data-engineers en ontwikkelaars tegenwoordig enorm veel tijd aan het beteugelen van de creativiteit van de bekende modellen. Traditionele autoregressieve modellen zoals GPT-4 en Claude zijn ontworpen voor brede, complexe generatietaken. Ze voorspellen tekst token voor token. Dit maakt ze zeer veelzijdig, maar tegelijkertijd minder efficiënt voor simpele binaire of meerkeuze-beslissingen. Ze zijn simpelweg relatief traag en computationeel duur wanneer de gewenste output enkel uit een 'ja', een 'nee' of een specifieke categorie-label hoeft te bestaan.
Ontwikkelaars lossen dit momenteel op door het model met ingewikkelde prompts en JSON-schema's te dwingen om een voorspelbaar antwoord te geven. Dit proces vereist echter nog steeds dat het model onder water de volledige autoregressieve cyclus doorloopt. Het model moet nadenken over het eerste token, het tweede token, de aanhalingstekens, en ga zo maar door. Dit introduceert onvermijdelijke latentie en verhoogt de kosten, wat schaalt naarmate de complexiteit van de workflow toeneemt.
De Jev-architectuur en RLCD uitgelegd
Jev is een nieuw type AI-model dat geen tekst genereert, maar uitsluitend getypte, probabilistische beslissingen neemt op basis van een gegeven context.
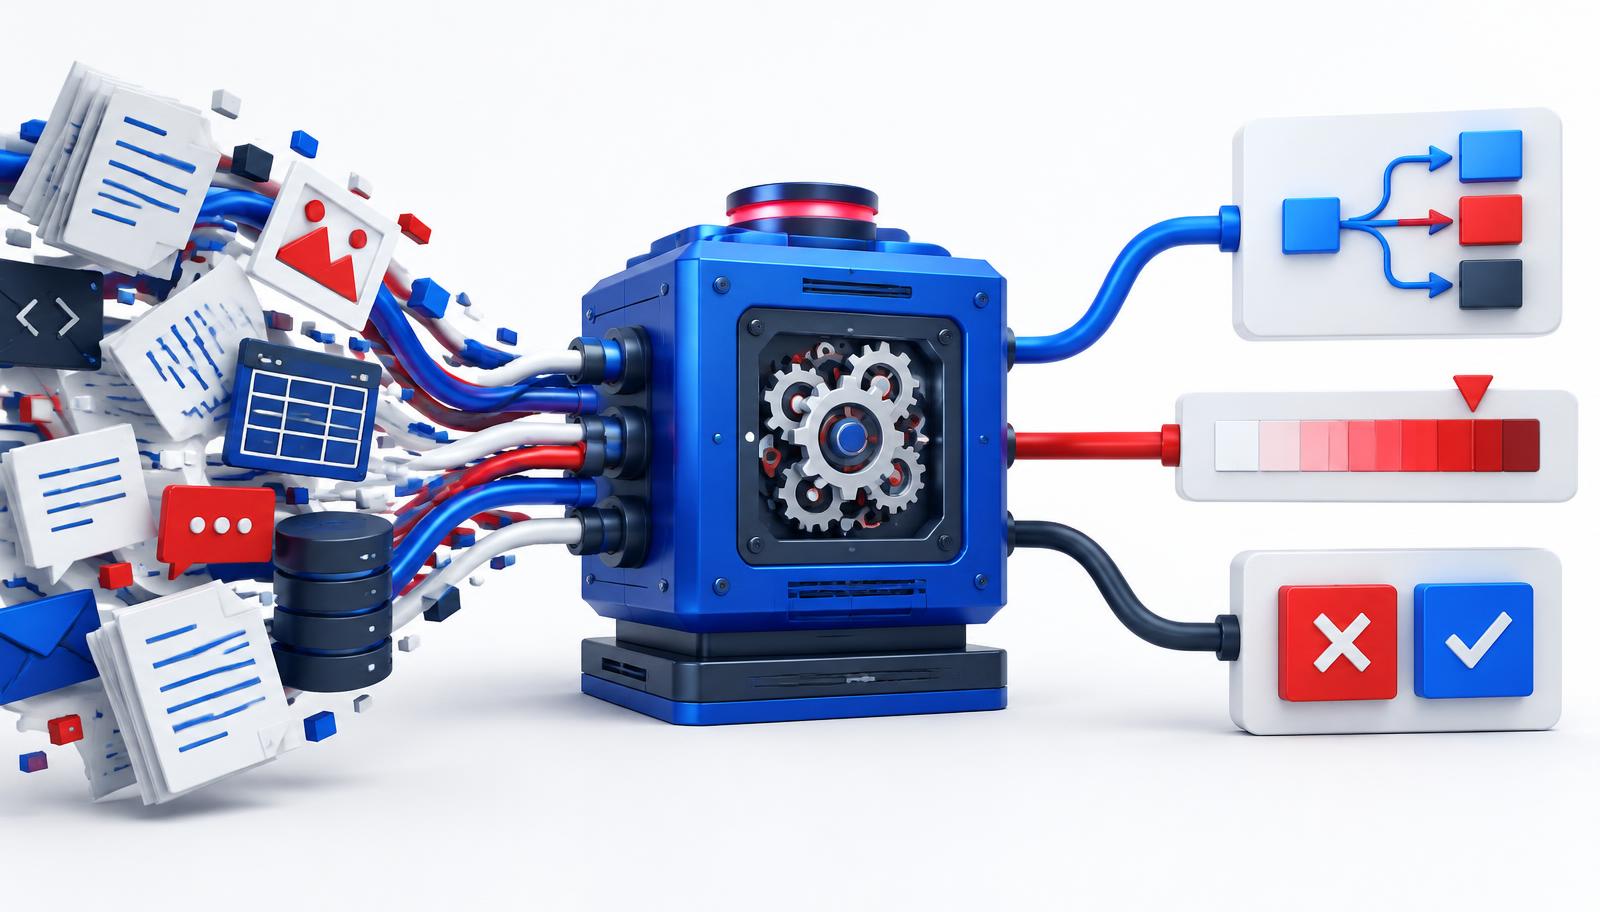
Jev pakt dit fundamentele knelpunt op een totaal andere manier aan. Het model weigert categorisch om vrij in de ruimte tekst te genereren. In plaats daarvan geven ontwikkelaars Jev een state (bijvoorbeeld de letterlijke inhoud van een inkomende klant-e-mail, aangevuld met metadata over de klant) en een vaste set specifieke vragen. Jev evalueert al deze gedefinieerde vragen parallel. Hierdoor wordt de vertraging die inherent verbonden is aan sequentiële tokengeneratie volledig omzeild.
Om deze parallelle architectuur mogelijk te maken, maakt TypeSafe naar eigen zeggen gebruik van een 'parallel sampler' en een unieke trainingsmethode die ze Reinforcement Learning for Calibrated Decisions noemen, oftewel RLCD. Door middel van RLCD leert het model niet welk woord logischerwijs op het vorige volgt, maar hoe het waarschijnlijkheden moet toekennen aan een vooraf vastgestelde reeks mogelijke uitkomsten. Dit betekent ook dat Jev geen test-time reasoning doet. Het pauzeert niet om intern een meerstaps denkpad uit te werken alvorens te antwoorden. Het is daardoor specifiek bedoeld voor snelle, afgebakende oordelen en expliciet niet geschikt voor zeer complexe redeneertaken waarbij de tussenstappen cruciaal zijn.
De drie API-primitieven: choice, score en noul
Om de interactie met het model uiterst gestructureerd te houden, dwingt Jev via de API het gebruik van drie strikte datatypen (primitieven) af. Omdat de architectuur parallel werkt, kunnen ontwikkelaars probleemloos meerdere verschillende vragen over dezelfde state afvuren zonder een significante toename in responstijd.
| Primitief | Beschrijving | Exacte Output Formaat |
|---|---|---|
| Choice | Kiest één specifieke, vooraf gedefinieerde optie uit een lijst die door de ontwikkelaar is bepaald. | De gekozen optie, een kansverdeling (probabilities) over álle opties, én een confidence-score. |
| Score | Evalueert de input over een reeks logisch geordende niveaus (bijvoorbeeld van extreem laag tot extreem hoog). | Een fractionele, gewogen score (bijv. 3.2), de probabilities per niveau, én een confidence-score. |
| Noul | Een razendsnelle binaire beslissing, speciaal voor repetitieve situaties met een hoge frequentie. | Uitsluitend een ja-kans (een waarde exact tussen 0 en 1). Bij Noul wordt géén aparte confidence-score geretourneerd. |
Zo ziet een Jev-aanroep eruit
De daadwerkelijke interactie met de gateway API van Jev verschilt in de kern wezenlijk van reguliere chat-API's. Er zijn geen berichtenarrays met 'user' of 'assistant' rollen. In plaats daarvan definieer je de state als een object, gebruik je lowercase datatypen en geef je per vraag exacte instructies en criteria mee.
{
  "model": "typesafe/jev-latest",
  "state": {
    "klantprofiel": "Premium abonnee, 3 jaar trouwe klant.",
    "bericht_tekst": "Mijn bestelling is zwaar beschadigd aangekomen en ik wil nu direct mijn geld terug, anders zeg ik op."
  },
  "questions": {
    "intentie": {
      "type": "choice",
      "instructions": "Bepaal de hoofdintentie van het bericht van deze klant.",
      "criteria": {
        "retour": "De klant wil een product terugsturen of zijn geld terugkrijgen.",
        "klacht": "De klant is ontevreden over de geleverde service of de levering zelf.",
        "opzegging": "De klant wil een bestaand abonnement of dienst per direct beëindigen."
      }
    },
    "urgentie": {
      "type": "score",
      "instructions": "Beoordeel hoe urgent dit verzoek is op basis van de emotie en de mogelijke bedrijfsrisico's.",
      "criteria": [
        "Geen haast, het is een standaard en neutraal informatieverzoek.",
        "Normale prioriteit, vereist actie binnen de standaard overeengekomen SLA.",
        "Kritiek, de klant is overduidelijk boos en dreigt met opzegging of verdere actie."
      ]
    },
    "escalatie_nodig": {
      "type": "noul",
      "instructions": "Moet dit ticket onmiddellijk naar een senior menselijke medewerker worden geëscaleerd?",
      "criteria": {
        "true": "De klant dreigt expliciet met opzeggen of uitte zware onvrede.",
        "false": "Het betreft een regulier verzoek zonder directe dreiging van churn."
      }
    }
  }
}
Prestaties, latency en de grens van benchmark-claims
Door de absolute focus op besluitvorming in plaats van vrije tekstgeneratie, positioneert Jev zich perfect voor enterprise-processen waar betrouwbare structuur en pure snelheid doorslaggevend zijn. Ter illustratie van de indrukwekkende verwerkingssnelheid demonstreerde TypeSafe bij de lancering een experimentele demo waarin Jev daadwerkelijk de klassieke videogame Doom speelt. Het model doet dit puur door op basis van een gestructureerde tekstuele spelstatus pijlsnel en in real-time acties te classificeren.
De huidige prijsstelling en prestaties in de early access-fase maken dit economisch schaalbaar. Als vendorinformatie meldt TypeSafe een actueel tarief van $0,042 per miljoen input-tokens, waarbij er voor output-tokens in het geheel geen kosten in rekening worden gebracht, gezien de beknopte aard van de output. Qua latency rapporteert TypeSafe grofweg 70 tot 500 milliseconden end-to-end responstijd per call. Volgens de eigen evaluaties van TypeSafe maakt dit Jev in specifieke agentic workflows tot 193,6 keer sneller en 444,6 keer goedkoper dan traditionele alternatieven. Het is echter absoluut cruciaal om te benadrukken dat dit nadrukkelijk uitersten zijn, voortkomend uit TypeSafe's eigen interne evaluaties op zeer specifieke taken. Gemiddelde resultaten of prestaties op afwijkende complexe taken kunnen sterk variëren, en er is op dit moment nog geen onafhankelijke, brede benchmark beschikbaar in de markt om deze aanzienlijke claims definitief te staven.
Schema-garanties: wat 'niet hallucineren' werkelijk betekent
Hoewel de vroege lancering logischerwijs veel aandacht trekt, klinken er in de AI-gemeenschap ook belangrijke genuanceerde geluiden en terechte kritiekpunten. Jev claimt in zijn marketingmateriaal dat het model "niet kan hallucineren". Voor leken klinkt dit als de absolute heilige graal, maar het is uitsluitend een vorm- en schema-garantie. Het betekent dat Jev onmogelijk een antwoord of label buiten de door de ontwikkelaar vastgelegde opties kan geven. Je code zal dus nooit vastlopen op een onverwacht tekstueel antwoord. Echter, het model kan inhoudelijk nog steeds de volledig verkeerde beslissing nemen. Een boze e-mail kan nog steeds per ongeluk geclassificeerd worden als een neutrale vraag; het antwoord past dan netjes in het schema, maar de beslissing zelf is simpelweg fout.
Daarnaast wijzen kritische experts in het veld, zoals AI-ontwikkelaar Sean Goedecke, erop dat de grote traditionele modellen steeds effectiever worden in het betrouwbaar forceren van gestructureerde output. Door via de API een regulier model te dwingen een restrictief JSON-schema of een grammaticastructuur te volgen, bereik je anno nu al een redelijk deel van de voorspelbaarheidsvoordelen. Doordat Jev bovendien geen test-time reasoning bezit, valt het voor zeer ingewikkelde routeringsvraagstukken al snel af. Hierdoor blijft de daadwerkelijke, langdurige competitieve voorsprong lastig onafhankelijk vast te stellen.
Het belang van groepsgewijs gekalibreerde confidence
Een van de belangrijkste technische pijlers van Jev is de nadruk op gekalibreerde confidence-scores bij de uitkomsten van Choice en Score. Maar wat betekent kalibratie hier precies? Let wel: 'gekalibreerd' betekent in de context van de RLCD-training dat het model uitsluitend groepsgewijs gekalibreerd is. Het garandeert absoluut niet dat één specifieke individuele voorspelling feitelijk honderd procent klopt, zelfs niet bij een hoge score. Het betekent simpelweg dat als je over een langere periode tienduizend beslissingen neemt waarbij het model stellig 90 procent confidence rapporteert, ook daadwerkelijk zo'n 90 procent van die specifieke groep beslissingen achteraf correct blijkt te zijn. Dit is existentieel voor de statistische betrouwbaarheid van een systeem over de gehele linie, maar biedt op microniveau bij de beoordeling van één losse klante-mail geen absolute feitelijke zekerheid.
De Jevons-paradox in agent-workflows
De extreme reductie in zowel kosten als latentie leidt onherroepelijk tot een fenomeen dat in de theorie bekendstaat als de Jevons-paradox. Toen stoommachines in de negentiende eeuw dankzij technologische vooruitgang efficiënter en goedkoper werden in het verbruik van steenkool, nam het totale wereldwijde verbruik van die steenkool paradoxaal genoeg exponentieel toe. Waarom? Omdat de verlaagde drempel plotseling talloze nieuwe, rendabele toepassingen ontsloot die voorheen ondenkbaar of onbetaalbaar waren.
Exact ditzelfde principe is nu van toepassing op besluitvorming binnen AI. Waarom bevat een echt robuuste agentic workflow tientallen verborgen beslismomenten? Omdat elk stukje binnengekomen data ideaal gezien langs meerdere controlepunten, ethische classificaties en veiligheidsvalidaties moet. Zodra het nemen van deze micro-beslissingen financieel en qua wachttijd vrijwel niets meer kost, zullen organisaties in Nederland massaal gigantische hoeveelheden beslissingen per seconde in hun processen integreren. Denk aan het real-time routeren van duizenden klantenservice-tickets per dag, het automatisch stroomlijnen en classificeren van zware logistieke documentstromen, en uitgebreide kwaliteitscontroles op de teksten die door andere, tragere AI-modellen zijn gegenereerd.
Onze take: dit verandert agentic workflows fundamenteel
Bij ai.nl bouwen en analyseren we dagelijks agentic workflows in gevestigde platformen zoals Copilot Studio, CrewAI, LangChain en n8n. In de praktijk merken we dat de vertraging en instabiliteit van de flow vrijwel altijd ontstaat op de momenten dat het systeem moet beslissen: Moet ik hier tool X of tool Y voor aanroepen? Bevat deze geëxtraheerde tekst gevoelige persoonsgegevens (PII)? Is de zonet gegenereerde samenvatting inhoudelijk wel accuraat genoeg om naar de klant te sturen?
Als het nemen van deze essentiële beslissingen daadwerkelijk en structureel twee ordes van grootte sneller en goedkoper wordt, dan forceert dit een fundamenteel nieuwe architectuur voor automatisering. Het wordt operationeel haalbaar om op élke iteratieve stap in een digitaal proces uitgebreide controles en strakke guardrails te plaatsen. Omdat Jev gekalibreerde kansen en probabilistische uitkomsten retourneert, maken deze modellen het bovendien mogelijk om expliciete, harde wiskundige drempels in te bouwen. Een concreet voorbeeldbeleid in je ticketingsysteem zou kunnen zijn: een gerapporteerde confidence boven de 0,95 triggert volautomatische verwerking zonder menselijke blik; een score tussen 0,70 en 0,95 escaleert de taak naar een senior medewerker ter controle; en alles onder de 0,70 wijst op te veel ambiguïteit en gaat direct terug in de triage-wachtrij. Het is wel essentieel te benadrukken dat dit slechts een abstract voorbeeldbeleid is, dat per specifieke toepassing in jouw organisatie nauwkeurig gevalideerd en gemonitord moet worden.
Dit brengt ons tot een duidelijke voorspelling. Dit is nadrukkelijk een opinie van ai.nl en geen vaststaand feit, maar we zien het luid en duidelijk: de benadering van TypeSafe is dermate specialistisch opgelost, en tegelijkertijd zo onmisbaar voor de grootschalige betrouwbaarheid van enterprise-agents, dat het bedrijf een uiterst logisch en strategisch overnamedoelwit vormt voor een groot frontierlab zoals OpenAI, Anthropic of Google. Dergelijke partijen zoeken immers continu naar manieren om hun eigen agent-frameworks robuuster te maken.
Ons praktische advies voor jou als bouwer? Wacht niet met innoveren tot Jev of vergelijkbare System One-modellen algemeen en breed beschikbaar zijn om je eigen workflows kritisch tegen het licht te houden. Inventariseer vandaag nog welke bestaande, trage LLM-aanroepen in jouw systemen feitelijk uitsluitend eindigen in een kort oordeel dat in drie woorden past. Dat zijn de exacte plekken waar je in de nabije toekomst het snelst gigantische efficiëntiewinst gaat boeken.
Bronnen
- Officiële lancering: Introducing System One Models and Jev (TypeSafe)
- TypeSafe API Primitives Documentatie
- TypeSafe Concepts: System One & Confidence
- TypeSafe Interne Evaluaties en Benchmarks
- Yahoo Finance / Business Wire: TypeSafe AI emerges from stealth with $40M
- The Register: TypeSafe AI debuts model for machines that plays Doom
- Sean Goedecke: Jev means structured output is interesting again
// Over de auteur
Remy Gieling
Mede-oprichter, AI-expert & bestseller-auteur
Tech-expert (1988) gespecialiseerd in kunstmatige intelligentie en mede-oprichter van ai.nl, The Automation Group, Proxies en eBrain.ai. Oud-hoofdredacteur van diverse zakenmerken en daardoor een geoefend verteller op het podium en in de media. Verzorgt jaarlijks 150+ AI-keynotes in binnen- en buitenland en is gastdocent aan Nyenrode. Co-auteur van zeven boeken, waaronder 'Handboek AI Strategie' en 'AI Agents', en bekend als presentator op radio en RTL Z. Reist langs de labs van OpenAI, Nvidia en Tencent en vertaalt de nieuwste doorbraken naar inzichten die leiders direct kunnen toepassen.
LinkedIn