Chinese AI-modellen zijn goed en spotgoedkoop. Het verschil zit straks in je data
Bij Huawei, Tencent en Xunce zagen Remy Gieling en Job van den Berg hoe Chinese taalmodellen de prijs van AI omlaag drukken. Waarom tokens een commodity worden en data het nieuwe goud is.
DeepSeek, Kimi, GLM, MiniMax, Qwen: Chinese taalmodellen staan inmiddels wereldwijd in de top van de downloadlijsten. Tijdens The AI Experience in Shenzhen kregen Remy Gieling en Job van den Berg bij Huawei, Tencent en databedrijf Xunce een kijkje achter de schermen. Hoe groot is de voorsprong, wat kost het en waar zit het echte voordeel?
Hoe kijkt China zelf naar de AI-race met de Verenigde Staten?
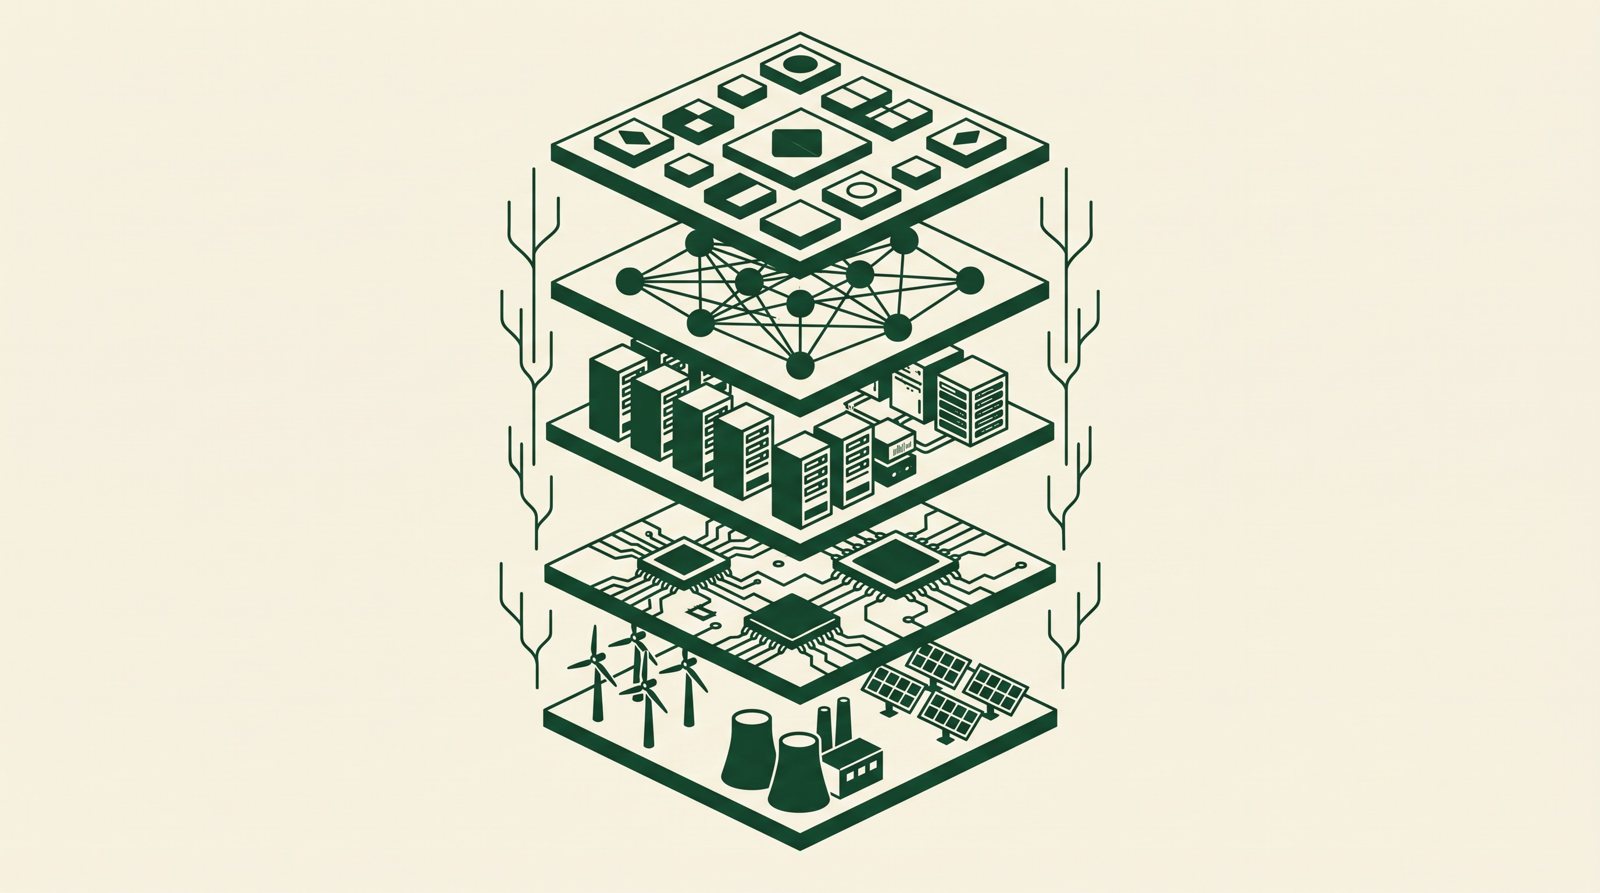
"Huawei liet een slide zien die ze de vijflaagse taart noemen. Interessant genoeg gebruikte Nvidia in Taipei een paar dagen eerder hetzelfde beeld. Onderin zit energie, dan chips, dan infrastructuur, dan de modellen en bovenin de toepassingen. Op bijna elke laag claimt China een structureel voordeel. Groene stroom in het westen van China kost volgens Huawei 3 à 4 dollarcent per kilowattuur, in de VS 6 tot 13 cent. Met vloeistofkoeling halen ze hun datacenters naar een zeer hoge efficiëntie. Die goedkope keten vertaalt zich direct in de prijs van een token."
Over welke prijsverschillen hebben we het dan?
"Flinke. Volgens Huawei kost DeepSeek V4-pro zo'n 0,87 dollar per miljoen tokens, tegen ongeveer 15 dollar voor GPT-5.4. Ze noemen dat zelf een tiende van de prijs. Tencent rekende voor dat je in hun Europese omgeving in Frankfurt ongeveer de helft bespaart op tokenkosten ten opzichte van rechtstreeks werken met Anthropic of OpenAI. Hun eigen model Hunyuan presteert volgens hen op frontierniveau voor een fractie van de prijs van Claude."
"En het volume is enorm. Volgens Huawei is het dagelijkse tokengebruik in China gestegen van 0,1 biljoen begin 2024 naar ruim 500 biljoen in juni dit jaar. Het grootste deel gaat naar videogeneratie, daarna komen agent-workflows en AI-coding. Gewone chat en search zijn nog maar zo'n vijf procent. De fase van de chatbot ligt daar al achter ons. Ze zitten midden in het tijdperk van agents."
Als modellen zo goedkoop worden, waar zit dan nog waarde?
"Dat was het mooiste moment bij Tencent. Ze zeiden het zelf: tokens worden steeds meer een commodity. Daarom steken ze hun energie in wat zij de harness noemen, alles rondom het model dat het bruikbaar maakt. Hun Token Hub geeft met één API-sleutel toegang tot meer dan twintig open-weight-modellen en routeert slim naar het goedkoopste model dat de taak aankan. Hun werkagent WorkBuddy heeft in China 85 miljoen maandelijkse gebruikers en kost zakelijk tien dollar per gebruiker per maand."
"En dan kom je bij data. Bij Xunce, dat zichzelf vergelijkt met Palantir, Databricks en Snowflake, zagen we hoe het werkt. Ze beginnen bij rauwe, ongestructureerde bedrijfsdata, maken die schoon, labelen en structureren haar, en bouwen daar per klant verticale modellen op. Ze hebben ruim vierhonderd herbruikbare modules en het labelen gaat inmiddels voor meer dan negentig procent automatisch. Zelfs grote modelbouwers als Kimi en SenseTime zijn klant. Die kunnen goede modellen trainen, maar hebben Xunce nodig om de data op orde te krijgen. Hun eigen vergelijking: zelfgemaakte burger tegenover McDonald's."
Kun je als Nederlandse organisatie veilig met Chinese modellen werken?
"Daar moet je zorgvuldig mee omgaan, en maak onderscheid tussen het model en de partij die het draait. De meeste Chinese modellen zijn open weight. Je kunt ze dus op je eigen infrastructuur of bij een Europese aanbieder laten draaien, zonder dat er data naar China gaat. Mistral biedt inmiddels GLM aan in zijn soevereine portfolio. Tencent en Huawei hebben datacenters in Europa en zeggen volledig AVG-proof te werken. Toch blijft het een geopolitieke afweging. Doe je due diligence op het contract, op waar de data staat en op wie er toegang toe heeft."
"Ik leg modellen altijd uit naar hun rol: de sprinter voor snelle, simpele taken, het werkpaard voor het bulkwerk en de Einstein voor het echte denkwerk. Huawei noemde een Italiaans bedrijf dat DeepSeek gebruikt voor routinematig programmeerwerk en Claude houdt voor complexe architectuurvragen. Dat is precies hoe je het moet doen. Kies per taak het juiste model op basis van nauwkeurigheid, kosten en snelheid, en meet dat met goede evaluaties."
Wat is jullie advies aan bestuurders?
"Ga ervan uit dat intelligentie steeds goedkoper wordt. Over een jaar betaal je voor hetzelfde werk een fractie van nu. Je strategie moet dus niet afhangen van één model of één leverancier. Bouw een architectuur waarin je modellen kunt wisselen."
"En investeer in je data. Als iedereen dezelfde modellen tegen dezelfde lage prijs kan gebruiken, zit je voordeel in wat alleen jij hebt: je bedrijfsdata, je processen en de kennis van je mensen. Huawei gaf er een nuchtere checklist bij. Heeft de toepassing aantoonbare waarde, is er een eigenaar, zijn de data er en kun je het blijvend beheren? Begin daar. Het model is het makkelijke deel geworden."